Jevは公開当日に再現された|5日後のGitHubに1,538件、いちばん星を集めたのは「Jevを使わないJev」
新しいAIが出たとき、先に真似されるのはモデルではなく「考え方」です。 2026年9月16日(日本時間)に公開された、文章を書かず判断だけを返すAI「Jev」。その5日後にGitHubを数えたら、Jev関連のリポジトリが1,538件ありました。そしていちばん星を集めていたのは、Jevを使わずに同じ仕組みを再現したプロジェクトで、しかもそれはJevの公開とほぼ同時に作られていました。
みやっち🧑💻はJev本体をまだ触っていません。この記事で自分の手で測ったのはGitHubの件数だけです。2026年9月21日にGitHubの検索APIで件数を数え、上位のリポジトリのREADMEと、そこに公開されているベンチマークを読んで書いています。後半に出てくる速度や精度の数字は、すべて各プロジェクトが自分で公表している値です。Jevが何をするAIかはJev(TypeSafe AI)とはにまとめているので、定義はそちらに譲ります。
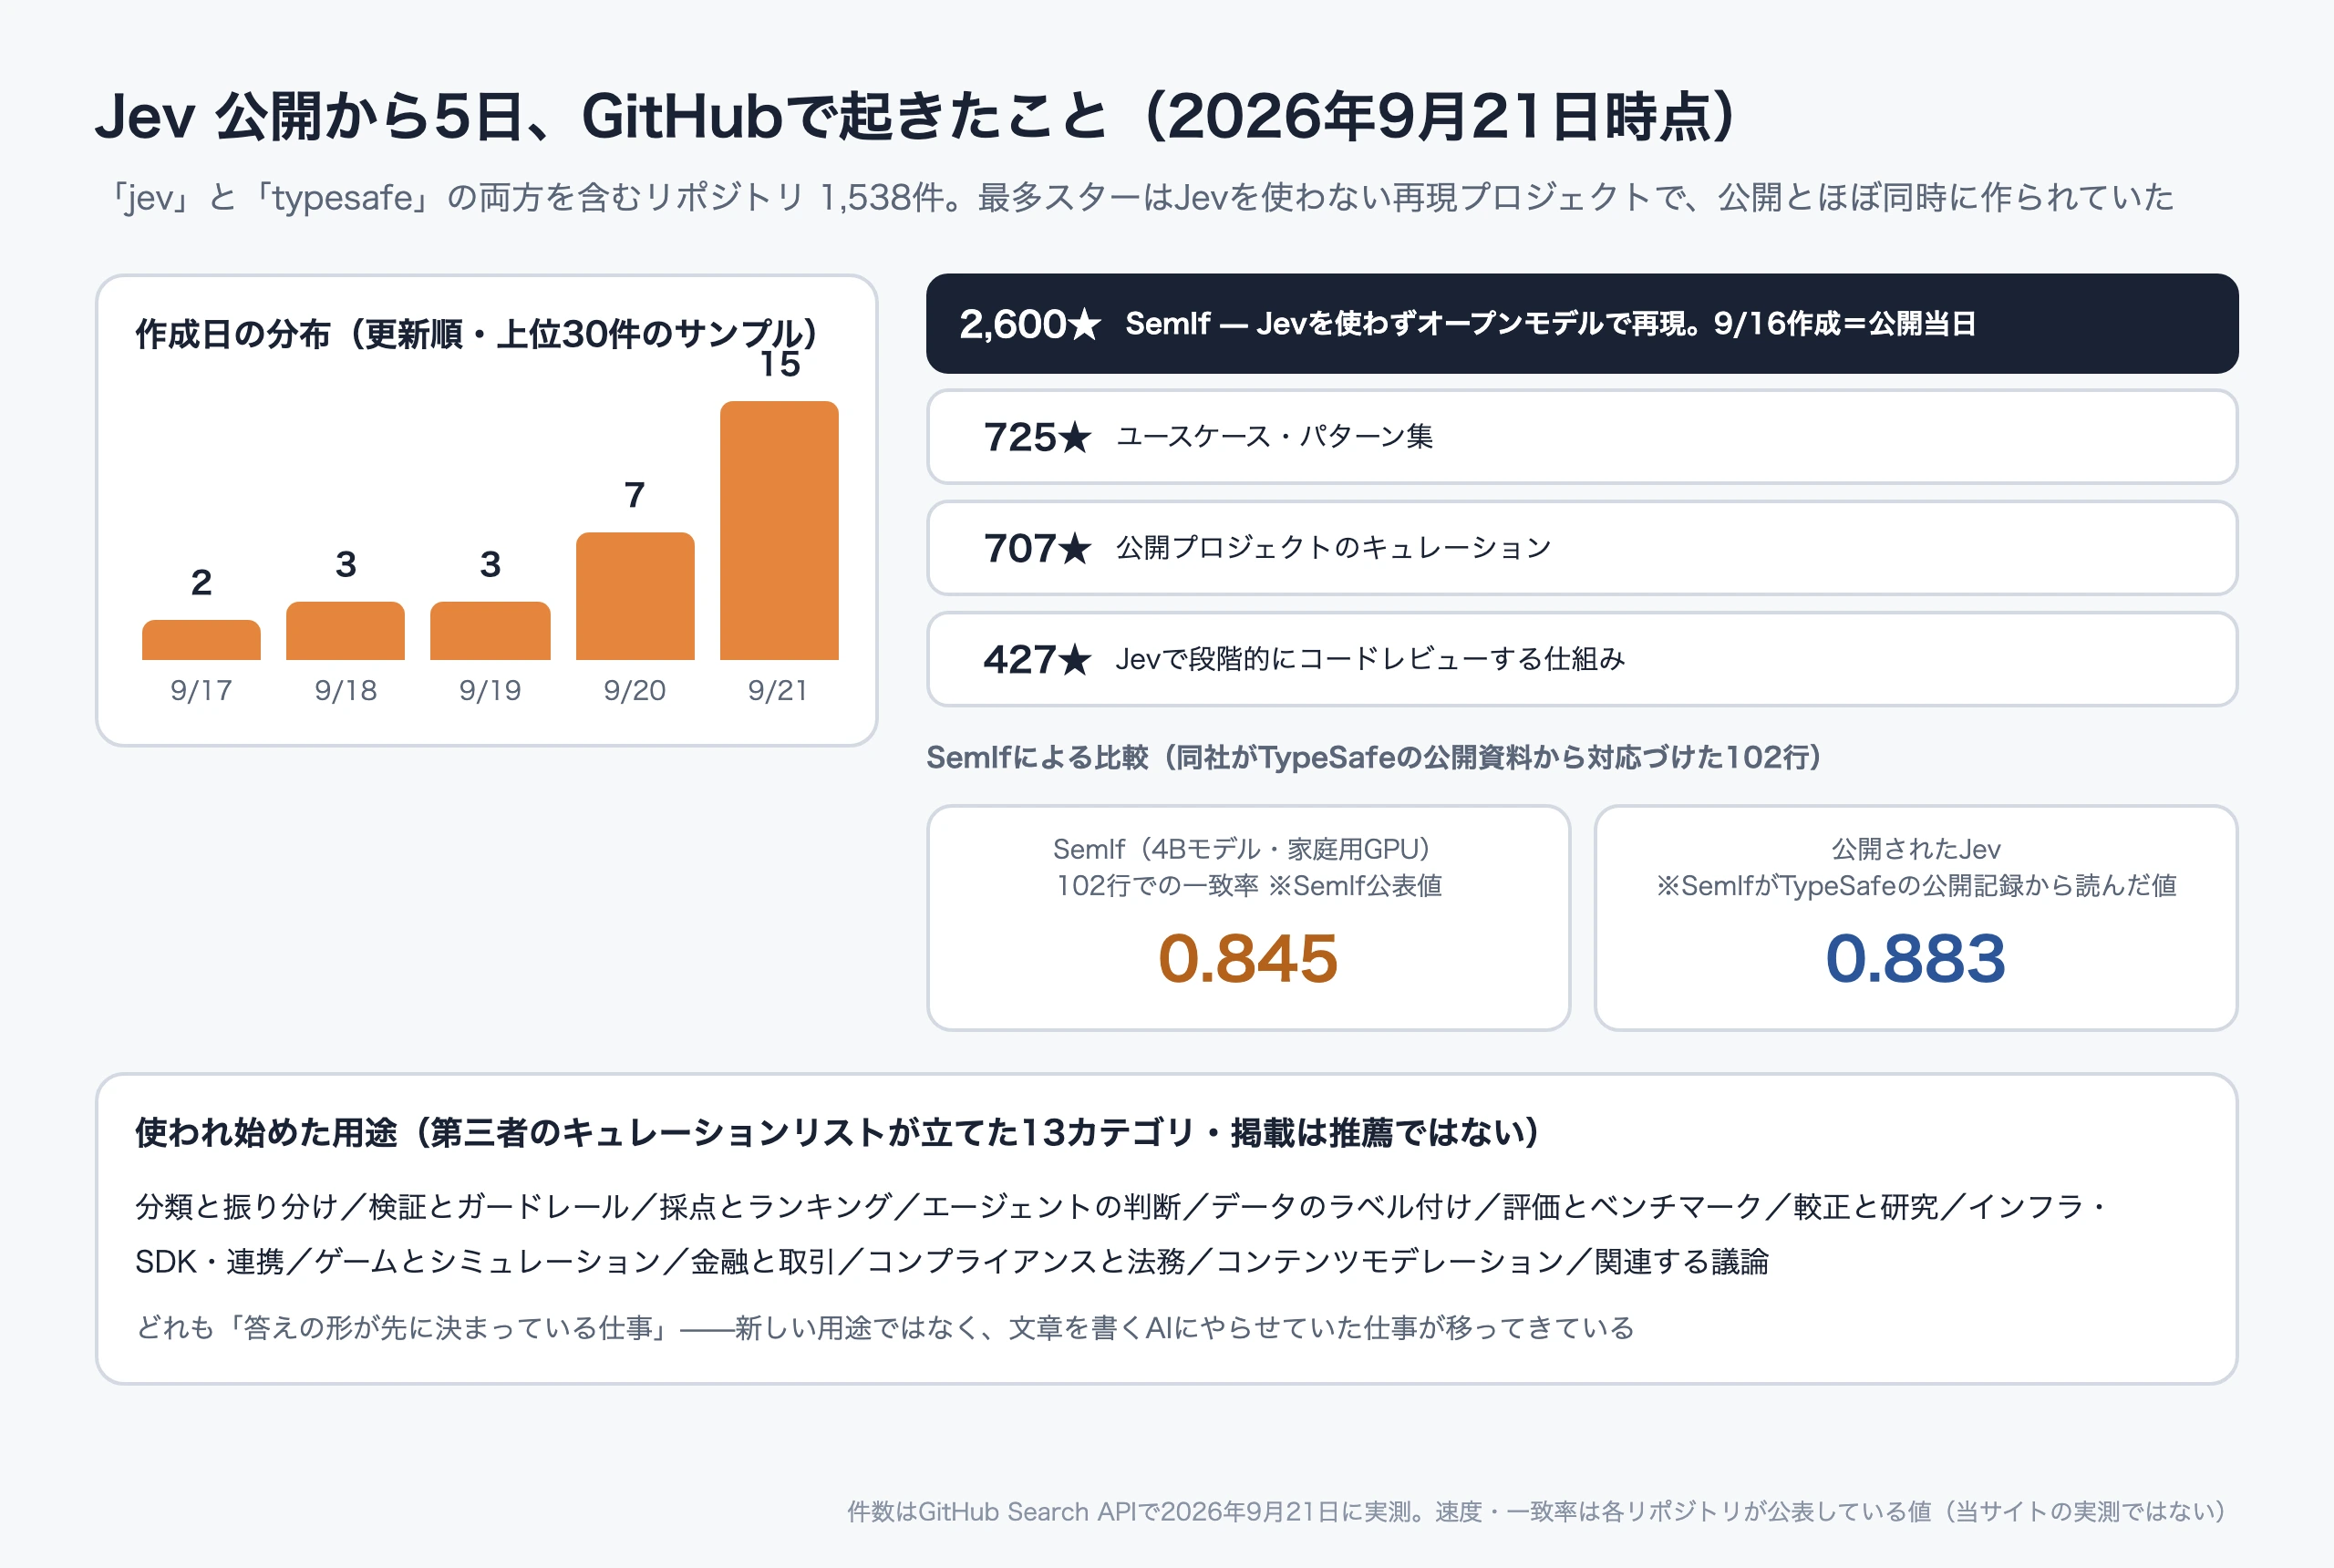
Jev公開5日後のGitHubの状況(2026年9月21日時点): 「jev」と「typesafe」の両方を含むリポジトリが1,538件。スター数の最多は2,600の「SemIf」で、これはJevのAPIを使わず、オープンモデル(Qwen3.5-4B)を家庭用GPUのRTX 3090で動かして同じインターフェースを再現した独立プロジェクト。SemIfが公表している比較では、TypeSafeが公開した102行のサブセットでの一致率はSemIfの4Bモデルが0.845、Jevが0.883(Jev側の数字はTypeSafeの公開記録から読んだ値で、SemIf側はJevを実際には動かしていない)。
何件あって、どう増えているのか
先に、数え方を書きます。「jev」は人名やアーティスト名にも使われる語なので、単独で検索しても当てになりません。そこで条件を変えて3通り数えました。
| 検索条件 | 件数 |
|---|---|
jev と typesafe の両方を含む | 1,538件 |
公式ドメイン typesafe.ai に言及している | 394件 |
名前に jev を含む | 6,595件(無関係なものを多く含むため不採用) |
この記事で使うのは真ん中の厳しめの条件、1,538件のほうです。より確実に「実際にAPIを触っている」側を見たいなら、公式ドメインに言及している394件が近い数字になります。
更新の新しい順に30件を取ってその作成日を見ると、9月17日が2件、18日が3件、19日が3件、20日が7件、21日が15件でした。直近の日ほど多く採れています。 ただしこれは「最近更新されたもの」から30件を抜いたサンプルなので、新しいリポジトリが構造的に多く入る取り方です。作成ペースそのものの証拠としては弱く、言えるのは「今も新しいものが作られ続けている」までです。
いちばん星を集めたのは「Jevを使わないJev」だった
スター順の上位から、Jevに関係するものを抜き出すとこうなります(無関係なプロジェクトが混じるため、関連するものだけを並べています)。
| ★ | 中身 |
|---|---|
| 2,600 | SemIf — オープンモデルでJevのインターフェースを再現(旧名OpenJev) |
| 725 | ユースケースとパターン集(※このリポジトリだけはJev公開前の2023年作成で、既存のものを転用した形) |
| 707 | 公開プロジェクトのキュレーション |
| 580 | ツール集 |
| 442 | Jevベースの「ソフトウェア工場の現場監督」 |
| 427 | Jevで段階的にコードレビューする仕組み |
| 407 | 公式資料とコミュニティのプロジェクト一覧 |
| 337 | Jevで検索する(ソース選択・クエリ理解) |
| 306 | 構造化された状態からスーパーマリオをプレイ |
2位以下を大きく引き離しているSemIfは、TypeSafeとは無関係の独立プロジェクトです。リポジトリが作られたのは2026年9月16日で、Jevの公開とほぼ同時。「調べるまでに5日かかった」だけで、再現そのものは初日に始まっていました。
キャッチコピーは「Semantic ifs from open models, on a 3090 at home」——家に置いたRTX 3090で、オープンモデルから意味的なif文を取り出す、という意味です。そして目立つところに「Wow! No waitlist.(ウェイトリストなんて要りません)」と書き、ブラウザで今すぐ動くデモを置いています。早期アクセス制で始まったJevを意識した一文に読めます。
SemIfは何を再現して、何を再現していないのか
ここを混同すると話がおかしくなるので、SemIf自身の線引きをそのまま書きます。
再現したのはインターフェースのパターンだけです。 READMEにはっきり書かれています——Jevの非公開のモデルや訓練を再現するものではない、と。再現したのは「状態と、実行時に決めた基準と、型付きの選択肢を渡すと、答えの文を1トークンも書かずに確率が返ってくる」という使い方の形のほうです。
仕組みも単純で、宣言された選択肢のlogits(モデルが各選択肢に与えた点数)を1回の順伝播で読むだけ。JSONを組み立てる工程がないので、生成そのものが発生しません。
速度: 同じモデルで5.21倍(SemIfの公表値)
SemIfが公開している実測です。同じQwen3.5-4Bを凍結して、同じ状態に対して21個の二値判定をさせています(RTX 3090が1枚、3回の中央値)。
| 出力の経路 | 時間 | 出力トークン |
|---|---|---|
| 型付きlogitsを直接読む | 1.023秒 | 0 |
| 自己回帰でJSON配列を書く | 5.332秒 | 111 |
5.21倍の差です。ただしSemIf自身が但し書きを付けています。21項目のうち一致したのは18項目なので、これは「2つの読み取り方が意味的に同じだ」という主張ではなく、システムとしての速度比較だ、と。最初のトークンが出るまでは0.489秒で、差がつくのは配列を書き終えるまでの区間です。
同じ状態を21個の基準で使い回す工夫も測っていて、都度スコアリングすると毎秒2.33件のところ、前置きを再利用して並列化すると毎秒20.03件まで上がります。777件の判定が333秒から39秒になる計算です。こちらも「速い経路は実験的で、777件中5〜6件で結論が変わった」と正直に書かれています。
精度: 4Bモデルで0.845、Jevが0.883(同じくSemIfの公表値)
TypeSafeが公開している102行のサブセットで、どれだけ同じ答えを出すかを比べた表です。これもSemIf側が作ったものです。
| システム | 一致率 |
|---|---|
| Qwen3-0.6B | 0.407 |
| MiniCPM5-2B | 0.637 |
| Qwen3.5-4B | 0.845 |
| 公開されたJev | 0.883 |
家庭用GPUで動く40億パラメータのモデルが0.845、Jevが0.883。差は0.038です。なお0.845はGPU上でBF16という精度で動かしたときの数字で、ブラウザで動かす軽量版はこれを圧縮した3.01GBの成果物として配られています。軽量版が同じ精度を出すわけではありません。
この比較には、SemIfが自分で挙げている限界が3つあります。①Jevの数字はTypeSafeが公開した記録から読んだもので、実際にJevのエンドポイントを動かしたわけではない ②突き合わせられたのは公開資料から対応が取れた102行で、TypeSafeが報告している711行の集計ではない ③返ってくる確率は渡した選択肢に依存するので、使う業務ごとに較正と検証が必要。
そのうえで、fixture・実行スクリプト・行単位の出力・モデルのリビジョン・プロンプト・既知の失敗まで全部リポジトリにコミットしてあります。第三者が追試するための材料が揃っているという点で、宣伝用に出された数字とは性質が違います。
Jevを実際に使う側は、何を作っているのか
再現プロジェクトばかりではありません。Jevを実際に呼んで作られたものの中で、設計がいちばん分かりやすかったのはコードレビューの仕組み(427★)でした。処理の流れがREADMEにそのまま書かれています。
- 真偽の確率でリスクの行列を作る
- 選択と採点で、ファイルの性質を判定する
- 選択で、証拠になる箇所を選ぶ
- 選択で、原因の種類を分類する
- 採点で、深刻度を付ける
- 条件を満たしたときだけ、選択でレビュー担当を振り分ける
注目したいのは、しきい値とワークフローの方針はコード側に置いていると明言していることです。AIに任せているのは1つ1つの判断だけで、「どうつなぐか」「どこで人に回すか」は人間が書いたコードが持っています。こちらも作者が限界を明記していて、静的解析やリポジトリの索引はまだ統合しておらず、出てきたものは「レビューのきっかけであって、欠陥の証明ではない」としています。
用途の広がりも見てみました。第三者がまとめているキュレーションリスト(707★・掲載は推薦ではないと明記)では、中身のあるカテゴリが13に分かれています。分類と振り分け、検証とガードレール、採点とランキング、エージェントの判断、データのラベル付けと整理、評価とベンチマーク、較正と研究、インフラ・SDK・連携、ゲームとシミュレーション、金融と取引、コンプライアンスと法務、コンテンツモデレーション、関連する実践と議論。
並べてみると分かりますが、どれも「答えの形が先に決まっている仕事」です。新しい用途が発明されたわけではなく、今まで文章を書くAIに無理やりやらせていた仕事が、そのまま移ってきています。
ここから読めること: 真似されるのは「考え方」のほうが先
前の記事で、みやっち🧑💻はこう書きました。「既存技術の延長にも見える。文章も推論も不要な分類なら、小さなモデルと出力を制約するデコードで近い速度が出る可能性があり、『専用モデルが必須か』はまだ確定していない」。
その検証が、公開の当日から始まっていました。 家庭用のGPUで動くモデルが、公表値とはいえ一致率で0.038差まで来ている。しかも手順が全部公開されていて、誰でも追試できる。
ただし「だからJevは要らない」という結論にはなりません。SemIf自身が、再現したのはインターフェースであってモデルではないと線を引いています。0.038の差を埋める部分、運用の安定性、自分でGPUを用意しなくていい手軽さは、まだJev側にあります。
経営者・個人事業主として受け取るべきなのは、もっと手前のことです。モデルは真似できなくても、設計の型は公開された翌日から誰でも使える。 新しいAIが出たとき、「このモデルを契約すべきか」と考える前に、「この考え方は自分の業務のどこに当てはまるか」を先に見たほうが、判断を間違えにくくなります。今回で言えば、答えの形が決まっている判断は、文章を書くAIに任せなくていい、という一点です。
そして今回のリポジトリを読んで改めてはっきりしたのは、うまく作られているものほど、AIに渡しているのは判断だけだということでした。コードレビューの例で言えば、しきい値も、どこで人に回すかも、人間が書いたコード側にあります。この線引きは、業務を回している本人にしか引けません。自分の業務で「どこまでをAIの判断に任せ、どこからを自分のルールで止めるか」を書き出す作業が、道具選びより先に来ます。前の記事の後半では、その箱の書き方を具体例で扱っています。
よくある質問
Jevは日本から使えるようになりましたか
2026年9月21日時点でも、一般提供の告知は出ておらず、早期アクセスの段階が続いています。ただし公式サイトのウェイトリストの申し込み導線は現在見当たらず、コンソールにサインインしてAPIキーを発行する案内に変わっています。料金は公開時と同じで、公式ドキュメントに入力100万トークンあたり0.042ドル・出力無料と記載されています。
SemIfを使えばJevの代わりになりますか
用途によります。SemIfが再現したのはJevの使い方の形であって、モデルそのものではありません。SemIfが公開している102行の比較では一致率0.845対0.883で、SemIf側が下です。加えて動かすにはオープンモデルを載せられるGPUか、Apple Silicon向けの実行環境、またはブラウザで動く軽量版が要ります。非エンジニアがすぐ業務に使えるものではなく、「同じ考え方が手元でも再現できると分かった」という意味で見るのが妥当です。
リポジトリが1,538件というのは多いのですか
比較する基準がないので「多い」と断定はできません。確かなのは、公開から5日の時点で1,538件が存在し、今も新しいものが作られ続けているということです。なお件数は検索条件で大きく変わり、公式ドメインへの言及に絞ると394件になります。
自分の業務でも「判断だけのAI」は使えますか
判断の回数によります。1日に数回なら、今のClaude Code・Codexにそのまま任せて問題ありません。効いてくるのは、同じ判断を大量に繰り返す場面です。詳しい線引きはJev(TypeSafe AI)とはの後半に書いています。
新しいAIを見るときの順番が変わる
今回いちばん面白かったのは、2,600の星が集まった先が「その製品を使わない実装」だったことです。公開されたのがモデルの重みではなく考え方だったから、その日のうちに再現が始まった。この順番は、これからも繰り返されるはずです。
だとすると、新しいAIのニュースを見たときに最初に立てる問いは「これは何ができるのか」ではなく、「この考え方は、自分の業務のどの判断に当てはまるのか」になります。そこまで具体化できていれば、使う道具がJevでも、その再現でも、今使っているClaude Code・Codexでも、成果はちゃんと出ます。
自分の業務にある「答えの形が決まっている判断」を書き出すところから始めてみてください。その具体例として、実際にJevへつないで業務10事例に落とした記録をJevを実際に動かして業務10事例を作らせたにまとめています。まず無料セミナーでお会いしましょう。
関連記事
GPT-6がChatGPTの通常チャットに登場|無料・Goは10月8日からLuna、Intelligent UIとは【2026年10月7日発表】
Claude Haiku 5.5とは|単価は前世代の10分の1、Opus 5.5・Sonnet 5.5との使い分け【2026年10月7日発表】
AntigravityでClaude Opus 5.5が選べるように|対象はGoogle AI ProとUltra、Claude 4.6は11月2日に削除【2026年10月】
Gemini 4 Argonが登場|まだ使えないGoogleの新世代モデル、一般向けは有料APIとAI Ultraから【2026年9月30日発表】