Jev(TypeSafe AI)とは|文章を書かないAIが外した「生成という税金」の正体【2026年9月16日発表】
Jevは「文章を書くAI」としては革命ではありません。革命に見えるのは、プロダクトの裏側で毎日いちばん多く回っている「判断・分類・振り分け」から、文章を生成するという余計な工程を外したからです。 2026年9月16日(米国時間)、TypeSafe AIという会社が、テキストを一切生成せず、あらかじめ決めた質問に対して「選択・採点・確率」だけを返すモデルJevを早期アクセスとして公開しました。みやっち🧑💻はまだJevを触っていません。この記事は公式ブログ・公式サイト・公式の評価ページを2026年9月17日に読み込み、「何が新しくて、何が盛りで、AIエージェントを作る側は何を考え直すべきか」を整理したものです。
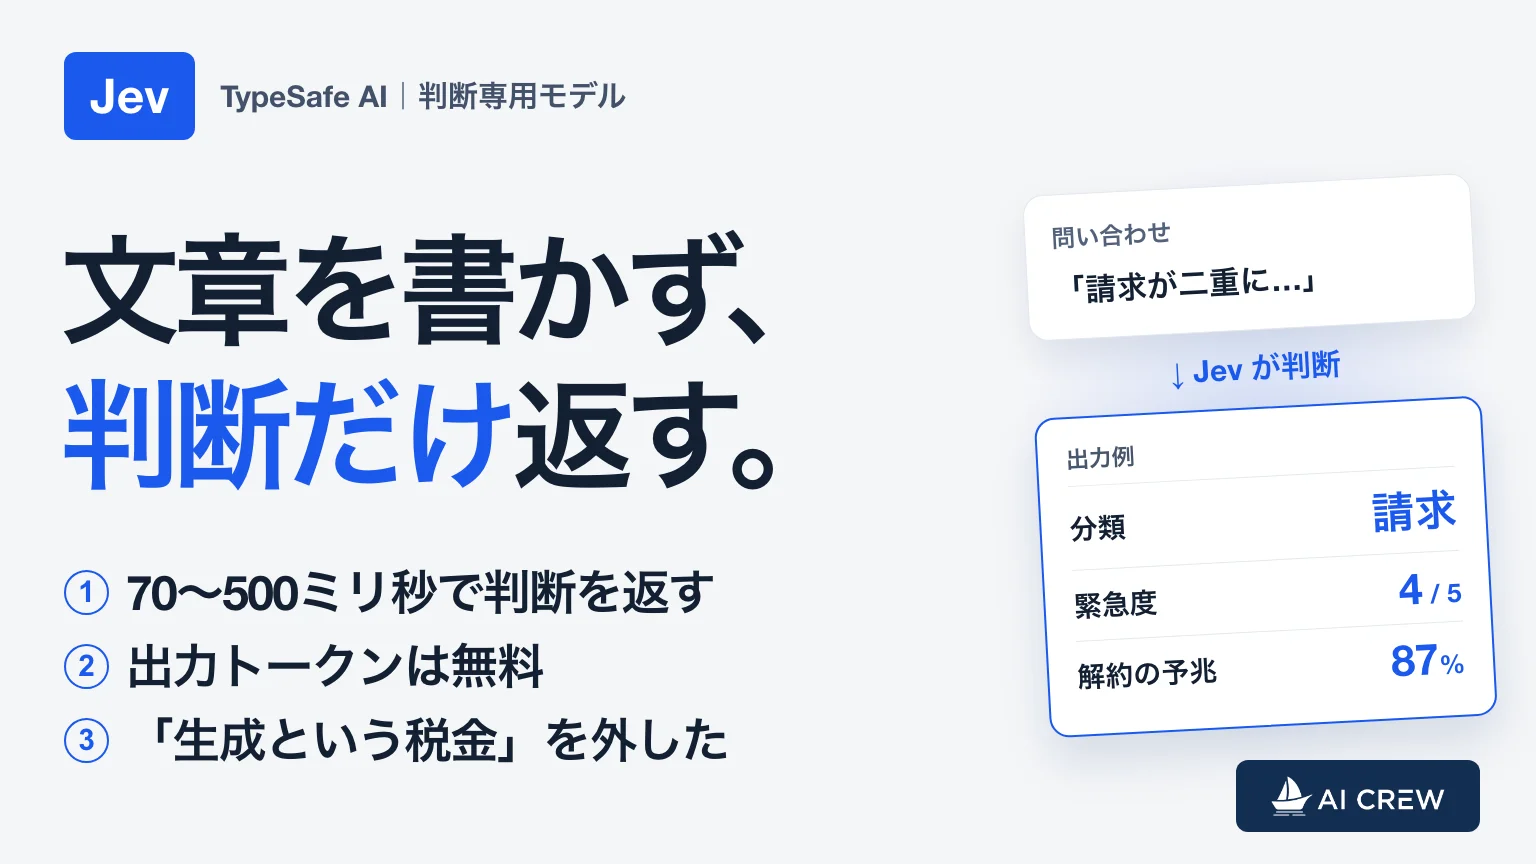
Jev(ジェブ)とは: TypeSafe AIが2026年9月16日に早期アクセスで公開した、同社が「System One Model」と呼ぶ新しい種類のAIモデル。文章を生成する代わりに、渡された状態(テキスト)と事前に決めた質問に対して、N個から1つを選ぶ・尺度で採点する・真偽の確率を返す、の3種類の型付きの答えを校正済みの確率つきで返す。公式が示す応答時間は70〜500ミリ秒、料金は入力100万トークンあたり0.042ドルで出力は無料。文章の生成・要約・説明はできない。
Jevは何をするAIか: 文章を書かず、箱を埋める
普通のLLM(大規模言語モデル)は、どんな質問にも「次の単語」を1つずつ書いて答えます。JSONで返してと頼んでも、内部では { "answer": という文字を順番に書いています。Jevはこの工程を丸ごと捨てました。公式ブログはJevを「フロンティア級の知能を持った関数呼び出し。構造化されていない状態を入れると、型付きの確率的な判断が出てくる」と定義しています。
渡すのは「状態」と「あらかじめ決めた質問」で、返ってくる答えの形は3種類だけです。
| 答えの型 | 何を返すか | 例 |
|---|---|---|
| 選択(Choice) | N個の選択肢から1つ | この問い合わせは「請求・技術・営業」のどれか |
| 採点(Score) | 決めた尺度での点数 | 緊急度を1〜5で |
| 真偽の確率(Noul) | 「これは真か」の確率 | この文はキャンセルの予兆か → 0.87 |
しかも複数の質問を1回で並列に評価し、それぞれの答えに校正済みの確率と確信度が付きます。JSONを一字ずつ書くのではなく、用意されたフォームの空欄を一度に埋めるモデルです。公式は「型のエラーを起こさない」と書いていますが、これは「正しい」という意味ではなく、「決めた形の外の値は出せない」という意味です。この違いは後で戻ってきます。
入力側は今までどおり言語です。問い合わせの本文、ログ、ゲームの状態を書いたテキストを読みます。捨てたのは出力側の言語だけ。つまりJevは「言語を理解するが、言語を生成しない」モデルです。
何が新しいのか: 生成という税金を外した
AIを使ったプロダクトを一度でも作った人なら分かるはずですが、チャットアプリでもない限り、アプリの内部でAIに頼んでいる仕事は構造化出力ばかりです。問い合わせを分類する、担当に振り分ける、優先度を付ける、危険な投稿を弾く、エージェントの次の一手を決める。どれも答えは「選択肢の中の1つ」か「点数」です。それを今まで、文章を書くために作られたモデルに「JSONで返してね」と頼んで回していました。この回り道にかかっていたコストを、この記事では「生成という税金」と呼びます。Jevが外したのはこの税金で、内訳は4つあります。
- 生成の工程そのものが消える。今のLLMにも構造化出力(Structured Outputs)があり、主要なAPIではスキーマに沿った形式で返すこと自体は保証されるようになりました。それでも内部では
{ "answer":をトークン単位で順に書いているので、生成の遅さと出力トークンの課金、長さ上限による途中切れや拒否時の例外処理は残ります。Jevは出力空間そのものがスキーマなので、この生成工程ごと不要になり、形式エラーは原理的に起きません - 速度がプロダクトの内部ループに乗る。公式が示す応答時間は70〜500ミリ秒。同じ判断をフロンティアLLMにさせると数秒から数分になると公式は比較しています。チャットなら2秒待てますが、振り分け・審査・エージェントの分岐・リアルタイム判定は待てません
- コストの構造が違う。入力は100万トークンあたり0.042ドル、出力は無料。「安いから全件判定できる」と「高いから間引く」の間には、設計の自由度の差があります
- 確率が「使える」前提で訓練されている。「怒っている」ではなく「0.87で怒っている」を返すので、閾値を決めて自動処理と人間レビューに分けられます。学習法にも「校正された判断のための強化学習(RLCD)」という名前を付けていて、確率の正直さを最初から狙っています
公式の評価ページの数字も置いておきます。TypeSafe AI自身が公開している4つのワークフロー(セキュリティインシデント・エージェントの動作ログ監視・請求書処理・カスタマーサービス)の平均で、2026年9月17日に評価ページの実値を確認しました。
| モデル | 一致率 | 1件のコスト | 応答時間 |
|---|---|---|---|
| Jev | 67.8% | 0.0004ドル | 0.4秒 |
| GPT-5.6 Terra | 67.9% | 0.0304ドル | 10.1秒 |
| GPT-5.6 Sol | 74.1% | 0.0836ドル | 23.3秒 |
| Claude Opus 5 | 73.1% | 0.1761ドル | 37.8秒 |
Terraと比べるなら約25倍速く、約76倍安い。公式サイトのトップに出ている「193.6倍速い・444.6倍安い」は、公式ブログ自身が「実運用での効果としては上限寄り」と補足している数字で、公式が併記している目安は「同じ水準の知能で40〜200倍速い」です。トップの数字はそのまま受け取らず、割り引いて読む必要があります。
革命ではない部分: 何ができないか
ここは大事なので、できることと同じ分量で書きます。
- 文章は一切生成しない。要約、説明、メールの下書き、コード生成はできません。ChatGPTやClaudeの代わりにはなりません
- ハルシネーションしないという説明は狭い意味。公式自身が、この0%は実測値ではなく「スキーマ外の値を構造上出せないことによる0%」だと説明しています。決めた選択肢の外の値は出せませんが、選択肢の中から間違ったものを高い確信度で選ぶことはできます
- なぜその判断なのかを説明しない。返ってくるのは選択と確率だけです。監査や説明責任が必要な場面では、別の仕組みで理由を補う必要があります
- 知能の比較は自社評価で、正解も人間ではない。上の表の「一致率」は、GPT-6 AstraとClaude Fable 5.1という上位2モデルの答えの平均を正解として、それにどれだけ一致したかです。「Terra並みに賢い」ではなく「選んだ4つの仕事で、Terraと同じくらい上位モデルの答えに同意する」が正確です。SolやOpus 5との差は開いています
- 既存技術の延長にも見える。文章も推論も不要な分類なら、小さなモデルと出力を制約するデコードで近い速度が出る可能性があり、「専用モデルが必須か」はまだ確定していません
まとめると、「AIの新時代」ではなく「生成モデルを分類器として使っていた無駄を、専用の設計で削った」が正確です。その無駄をこれまで払ってきた人には革命に見え、チャットの画面を作っている人にはあまり革命に見えない。温度差の正体はそこです。
なぜ今まで誰も作らなかったのか
ここが、みやっち🧑💻が今回いちばん考えたところです。「特定の型で返す」「ファンクションコーリング」という発想は何年も前からありました。なぜ、推論を判断だけに使うモデルが商品として出てこなかったのか。
答えの前半は「昔はむしろこっちが本流だった」です。2018年から2022年ごろの実務のAIは、ほとんどが分類器でした。問い合わせの分類、スパム判定、与信、レコメンド。言語を「書いて返す」のではなく「読んでラベルにする」モデルを、仕事ごとに1つずつ学習させていました。Jevの祖先はこちらです。
それがChatGPT以降、一気にLLMに寄りました。理由は技術の盲点ではなく、経済とUXです。
- 1つのモデルで全部そこそこできるほうが、会社として楽だった。分類器は仕事ごとにデータを集めて学習・評価・再学習が要る。LLMならプロンプトを変えるだけで翌日出せる。精度が少し落ちても、開発速度が桁違いでした
- 研究と資本が「次の単語を予測する」ことに集中した。チャットという分かりやすい商品になり、投資家も利用者も「話せるAI」は理解できた。「70ミリ秒で確率を返すAI」は、エージェントが日常になるまで需要が見えにくかった
- ファンクションコーリングもJSONモードも、生成モデルの上に後から足した互換レイヤーだった。新しい種類のモデルを作るより、既存の巨大モデルに「この形で書け」と制限するほうが早かった。だから発想はあったのに、中身は相変わらず文字を順番に書いていました
- 痛みがまだ小さかった。ChatGPT以降しばらくの典型的な使い方は、利用者の1発言につきLLMを1回呼ぶこと。2秒待ってJSONがたまに壊れても、再試行すれば足りた。限界が来たのは、エージェントが内部で何十回も分岐し、判断の回数が桁で増えてからです
つまり、生成を捨てたモデルは「発想がなかった」のではなく、「生成を捨てることが商品になると証明できる市場」が先に必要でした。Jevが今出てきたのは、AIエージェントの開発が盛り上がり、その市場が先にできたからだと、みやっち🧑💻は見ています。消費者向けではなく開発者向けなので、見た目は地味です。それでも成立するのは、裏側で判断を回す開発者の数が、この2年で桁違いに増えたからです。
「全部を言語に統一する」メリットは、開発者側にはなかった
ここが、みやっち🧑💻がこの発表から受け取った本質です。
LLMは「入力も出力も自然言語」に統一しました。人間が相手ならそれは正しい。人間は文章で読みたいし、文章で頼みたい。けれど、アプリの内部でAIの答えを受け取るのはプログラムです。プログラムが欲しいのは「営業」というラベルと「0.87」という数字であって、「この問い合わせは営業に関するものだと考えられます。理由は……」という文章ではありません。開発者側には、答えを言語に統一するメリットが最初からなかった。むしろ、言語で受け取るからパースが要り、壊れ、遅く、高くなっていた。
Jevは、その「言語に統一しない」側に賭けたモデルです。入力の理解にはフロンティア級の言語理解を残し、出力からは言語を外した。伝統的な識別モデルに、フロンティア級の読解力を載せたもの、と言えば近いと思います。
そしてこの分岐は、今後さらにはっきりします。チャットと長い思考はLLM、高速な箱埋めは専用モデル。専用モデル同士の勝負は、文章のうまさではなく「短い判断の精度・確率の正直さ・応答時間」で決まる。今後は「Jevのような構造化出力専用モデル」の中で性能の濃淡が出てくるはずです。
AIエージェントを作る人は、何を考え直すべきか
Jevをすぐ使うかどうかより大事なのは、「推論をどの局面で使うか」を設計する視点を持つことです。
身近な例を2つ挙げます。1つ目は、Claude Code・Codexの/goalコマンドの記事で教材の例文として紹介した、アンケートの「ご意見」列を全件分類する型です。分類ルールにないカテゴリは作らない、件数の合計が元データと一致したら完了。これは典型的な「箱を埋める」仕事で、この型ではClaude Code・Codexという生成モデルに箱埋めをさせています。2つ目は、このサイトの実際の運用です。毎朝、その日のAIニュースの候補を「記事にする・見送る」に振り分ける仕組みをClaude Codeで動かしています。これも判断です。
この2つは、どちらも今のままでいいと考えています。理由は回数です。アンケートの集計のような仕事は回数が限られ、ニュースの判定は1日1回。数秒待っても、たまに再試行しても困りません。Jevのようなモデルが効くのは、同じ判断を1日に何千回・何万回と回す場面、あるいは100ミリ秒単位で次の一手が必要な場面です。
ただ、視点は変わります。今までは「とりあえず全部AIに文章で聞く」で作っていた。これからは、自分の業務の中で「答えの形が先に決まっている判断」がどこにあるかを見つけ、そこは箱を先に決めてから作る。これが、Jevが出た後のAIエージェントの作り方です。「請求・技術・営業のどれか」「緊急度1〜5」「キャンセル予兆かどうか」という箱を書けるのは、その業務を回している本人だけです。
だからこそ、AIエージェントの作り方の記事で書いたとおり、Claude Code・Codexに自分の業務手順と判断基準を読み込ませて育てる価値があります。今は判断も生成もClaude Code・Codexに任せて動くものを作り、判断の回数が増えて税金が重くなった箱から、Jevのような専用モデルに差し替えていく。この順番で作れる人が、次の2年で強くなると思います。
よくある質問
JevはChatGPTやClaudeの代わりになりますか
なりません。Jevは文章を一切生成しないので、要約・説明・メール作成・コード生成はできません。Jevが置き換えるのは、アプリの内部で「JSONで返して」と頼んでいた分類・振り分け・採点の部分だけです。チャットや長い思考は、これまでどおりLLMの仕事です。
Jevは日本から使えますか
2026年9月17日時点では、公式サイトのウェイトリストから申し込む早期アクセスの段階で、一般提供は始まっていません。公式サイトのバージョン表記も0.01です。料金は公式ブログに入力100万トークンあたり0.042ドル・出力無料と記載されていますが、提供条件は変わる可能性があります。
Claude Code・CodexとJevは競合しますか
競合しません。Claude Code・Codexは、文章を生成し、ファイルを操作し、ツールを呼び出して仕事を進めるAIエージェントです。Jevはそのエージェントが内部で使う「判断の部品」にあたります。エージェントの分岐や振り分けをJevに任せ、生成と実行はClaude Code・Codexが担う、という組み合わせが自然な形です。
「ハルシネーションしない」というのは本当ですか
「決めた選択肢の外の値を出せない」という意味では本当で、公式もそう説明しています。ただし公式自身が、ハルシネーション率0%は実測値ではなく、スキーマ外の値を構造上出せないことによる数字だと説明しています。選択肢の中から間違ったものを高い確信度で選ぶことはあり得るので、確率の閾値と人間のレビューを組み合わせる設計が前提です。
「どこで推論を使うか」を決める側になる
Jevが示したのは、AIの進化の方向が「もっと賢く話す」の一本ではない、ということです。判断だけを速く安く正直に返す、という別の方向が商品になった。これからAIエージェントを作る人は、チャットに全部を投げる側ではなく、「この判断はどの種類のモデルに任せるか」を決める側に立つことになります。
その第一歩は、自分の業務の中にある「答えの形が決まっている判断」を書き出すことです。分類のルール、優先度の基準、人に回す条件。それを自分の言葉で書けるようになると、Claude Code・Codexで作るエージェントの設計が一段変わります。まず無料セミナーでお会いしましょう。