YouTubeのサムネイルをAIで作る方法|画像生成に任せる部分と、人が固定する4つの文法
先に結論です。YouTubeのサムネイルを画像生成AIで作るなら、入れる文字と、毎回そろえる「文法」は人が決め、絵の作り込みと案出しをAIに任せる、という分担にしてください。AIに丸ごと頼むと、指定していない文字が足されることがあります。みやっち🧑💻の自分のYouTubeの1本目で、実際にそれが起きました。
YouTubeサムネイルをAIで作るとは ChatGPTの画像生成(ChatGPT Images)やOpenAIの画像モデルGPT Imageなどの画像生成AIに、写真や参考の1枚と指示文を渡して、動画のサムネイル画像を作らせることです。AIに任せるのは絵の作り込みと案出しで、サムネイルに入れる文字・毎回そろえる見せ方・最終の判断は人が持ちます。
YouTubeやセミナー動画を出し始めた個人事業主・一人社長に向けて、1本目で起きたことと、そこから決めた作り方を順に書きます。
AIで作ったサムネイルが「みんな同じ」に見える問題
動画編集はAIでできるようになってきました(どこまでできたかはClaude Code・Codexで動画編集はどこまでできるかに書いています)。それでも、サムネイルはサムネイルで1から考えないといけない。ここが本当に難しいところです。
みやっち🧑💻は1本目のとき、一日中、おかしくなるぐらいサムネイルを見続けました。そこで感じたのが「AI系のサムネイルって、みんな同じに見えないか」ということです。目を引いてクリックしたくなるのは前提として、そのうえで「このサムネイル、あの人だよね」と思ってもらえる個性も欲しい。画像生成AIに頼めば1枚はすぐ出てきますが、この「自分らしさ」はAIが勝手には持ってきてくれません。
1本目で起きたこと:AIが指定していない文字を足した
1本目のサムネイルは、Codexに組み込まれた画像生成(GPT Image)で、16:9のサイズを指定して作りました。
最初に出てきた案には、こちらが指定していない文字が勝手に足されていました。みやっち🧑💻が「指定した以上の文字は入れない」と直して、そこからルールにしたのが次の線引きです。
- サムネイルに入れる文字は、みやっち🧑💻が台本の「サムネイル」欄に書いた文言だけ
- 画面・書類・カードの中に描かれる文字も足さない
- 何かを描くなら、読める文字のない図形やぼかしにする
案の出し方は、次の順で絞りました。
- みやっち🧑💻がスクリーンショットで示した見せ方(左右のビフォーアフター、「変化前→変化後」の数字、指さし、下に大きなモデル名)から4案
- 方向を変えて、白ベース+オレンジ1色の3案も並べる。選んだのは派手めの案のほう
- 選んだ案のモデル名と時間の見せ方を残し、補助の言葉・写真・背景を変えた4案から確定
途中で版を重ねながら、確定したサムネイルの文字は3つだけになりました。業務名、時間の変化、モデル名です。写真は撮影素材のカメラ映像から、本人の上半身を切り抜いて使っています。
全部を同じにせず「文法」だけをそろえる
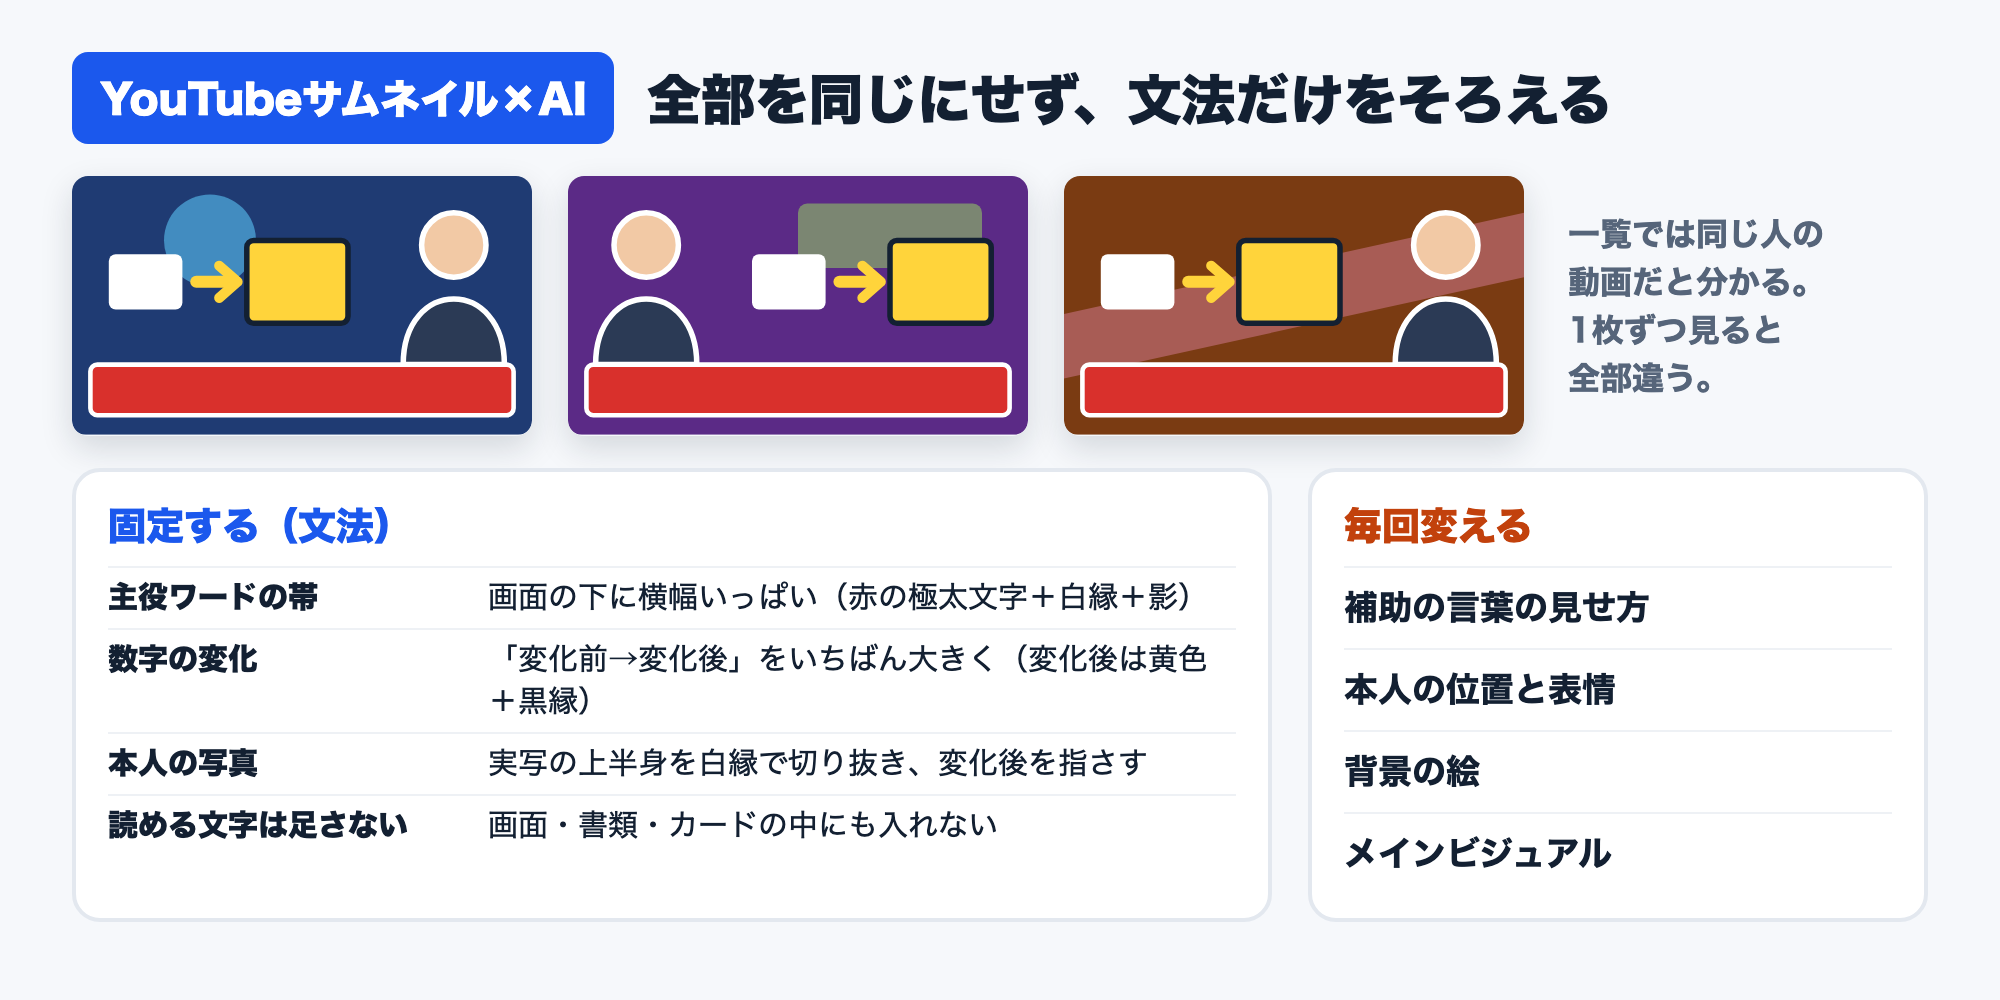
「みんな同じに見える」への答えとしてたどり着いたのが、全部を同じにせず、文法だけをそろえるという考え方です。一覧に並んだときは「あの人の動画だ」と一瞬で分かり、1枚ずつ見ると全部違う。そのために、確定した「正解の1枚」から文法を取り出し、回を重ねて直していきます。
| 中身 | |
|---|---|
| 固定する① 主役ワード | モデル名などの主役ワードは、画面の下に横幅いっぱい(赤の明朝系の極太文字+白の太い縁+影) |
| 固定する② 数字の変化 | 「変化前→変化後」をいちばん大きな文字で。変化前は白、矢印と変化後は黄色+黒縁 |
| 固定する③ 本人の写真 | 実写の上半身を細い白縁で切り抜き、変化後を指さす |
| 固定する④ 読める文字 | 画面・書類・カードの中に読める文字を入れない |
| 毎回変える | 補助の言葉の見せ方、本人の位置と表情、背景の絵、メインビジュアル |
固定するのは「どこに・何を・どの強さで置くか」という骨組みで、変えるのは中身の絵です。ここを決めておくと、毎回のサムネイル作りは「今回は何を変えるか」を考えるだけになります。
画像生成AIへの指示に必ず書く4つのこと
文法が決まったら、画像生成AIへの頼み方も型にします。参照画像は2枚で、1枚目が本人の写真、2枚目が「正解の1枚」です。そのうえで、指示文には次の4つを必ず書きます。
- 2枚目からそのまま残す要素と、この案で変える要素(上の表の「固定する」と「毎回変える」をそのまま使う)
- 使ってよい文字の全部と、「ほかの文字は画面・書類・カードの中も含めて入れない」という一文
- 本人の顔・髪型・服を変えないこと
- 全部の要素を枠の中に収めること
2は、1本目で指定外の文字を足されたことから加えた項目です。使ってよい文字を並べるだけでなく、足してほしくないものは「入れない」とはっきり書きます。
1枚で判断せず、スマホの一覧で12〜20枚並べて確かめる
できたサムネイルは、1枚だけを大きく見て判断しません。スマホの一覧の大きさで、自分の過去のサムネイルや同じジャンルの動画と12〜20枚並べて見る、と決めています。
- 全部が同じに見えたら、毎回変える要素を増やす
- バラバラに見えたら、固定する要素を増やす
視聴者がサムネイルを目にするのは一覧の中なので、判断も一覧の大きさでします。
ブログのサムネイルは文字を画像生成に描かせない
同じサムネイルでも、このサイト(AI Crew)のブログでは別の解き方をしています。ブログのサムネイルは、画像生成AIに文字を描かせません。記事ごとの主役の絵だけを文字なしの素材として用意し、タイトルや説明の文字はHTML/CSSで組んで画像に書き出しています(この記事のサムネイルもその方法です)。書き出したら、完成画像と350px幅の一覧表示を全部目で見て、文字・図・ロゴが重なっていないか、読めるかを確かめます。
使い分けの考え方は単純です。
- 文字の正確さと量産が要るもの(ブログ):文字は組版で入れる
- 写真と勢いが要るもの(YouTube):画像生成で作り、文字は指定したものだけに絞る
どちらも「文字は人が決めたものだけ」という点は同じです。違うのは、その文字をAIに描かせるか、組版で載せるかです。
サムネイル作りが「毎回1から」でなくなる
状態の変化で言うと、こうです。
- これまで:動画ごとにサムネイルを1から考え、一日中見比べても、AI系のサムネイルはみんな同じに見えてしまう
- 文法を決めたあと:骨組みは固定済み。毎回考えるのは「今回は何を変えるか」と、使う文字だけ。あとは参照画像2枚と指示4点でAIに案を出させ、一覧で並べて選ぶ
ここで効いているのは、画像生成AIの性能より、自分の正解の1枚・固定する要素・指示の型を手元に残して、次の回にそのまま渡せることです。みやっち🧑💻は、決めたルールをYouTube制作の記録に書き足しながら回しています。チャットでその都度お願いするだけだと、この型は毎回こちらが思い出して書き直すことになります。
Claude Code・Codexのように自分のパソコンで動くAIエージェントなら、本人の写真・正解の1枚・ルールの文書をファイルのまま読ませて作業させられます。画像生成をこうした手順書として組み込む仕組みはClaude Codeのスキルの実例で、画像生成AIそのものの選び方は画像生成AIのガイドで整理しています。
よくある質問
画像生成AIはサムネイルに日本語の文字をきれいに入れられますか
みやっち🧑💻の1本目では、文字そのものより「指定していない文字が足される」ことが問題になりました。使ってよい文字を全部書き、ほかの文字は入れないと明記して作っています。文字の正確さを最優先したい場合は、このサイトのブログのように、絵だけを画像生成で作り、文字は後から組版で載せる方法もあります。
サムネイルの参考にする「正解の1枚」はどうやって決めますか
最初から1枚に決め打ちせず、見せ方の違う案を何案か並べて選びます。みやっち🧑💻の1本目は、4案、方向を変えた3案、さらに4案と並べて確定しました。確定した1枚が、次の回からの「正解の1枚」になります。
自分の写真をAIに渡すとき、気をつけることはありますか
指示文に「本人の顔・髪型・服を変えない」と必ず書きます。みやっち🧑💻は、本人の写真を1枚目の参照画像として渡し、この一文を指示の型に入れています。サムネイルに載せる写真は、撮影素材から上半身を切り抜いたものです。
自分のやり方を型にして、AIに毎回そのまま渡す。サムネイルに限らず、この考え方で仕事を組み直すところを講座では扱っています。まず無料セミナーでお会いしましょう。